Chapter 12 — Investigation Engine: từ tín hiệu rời rạc đến kết luận có bằng chứng
Investigation Engine không phải chatbot biết đọc dashboard. Nó là hệ thống quản lý một cuộc điều tra: giữ nhiều giả thuyết cạnh tranh, chọn bằng chứng có giá trị nhất, phân biệt fact với suy luận, hạ độ tin cậy khi telemetry thiếu và dừng đúng lúc khi chưa đủ căn cứ. LLM có thể giúp đọc, tổng hợp và lập kế hoạch truy vấn; LLM không được trở thành nguồn sự thật, bộ thực thi hay người quyết định thay on-call.
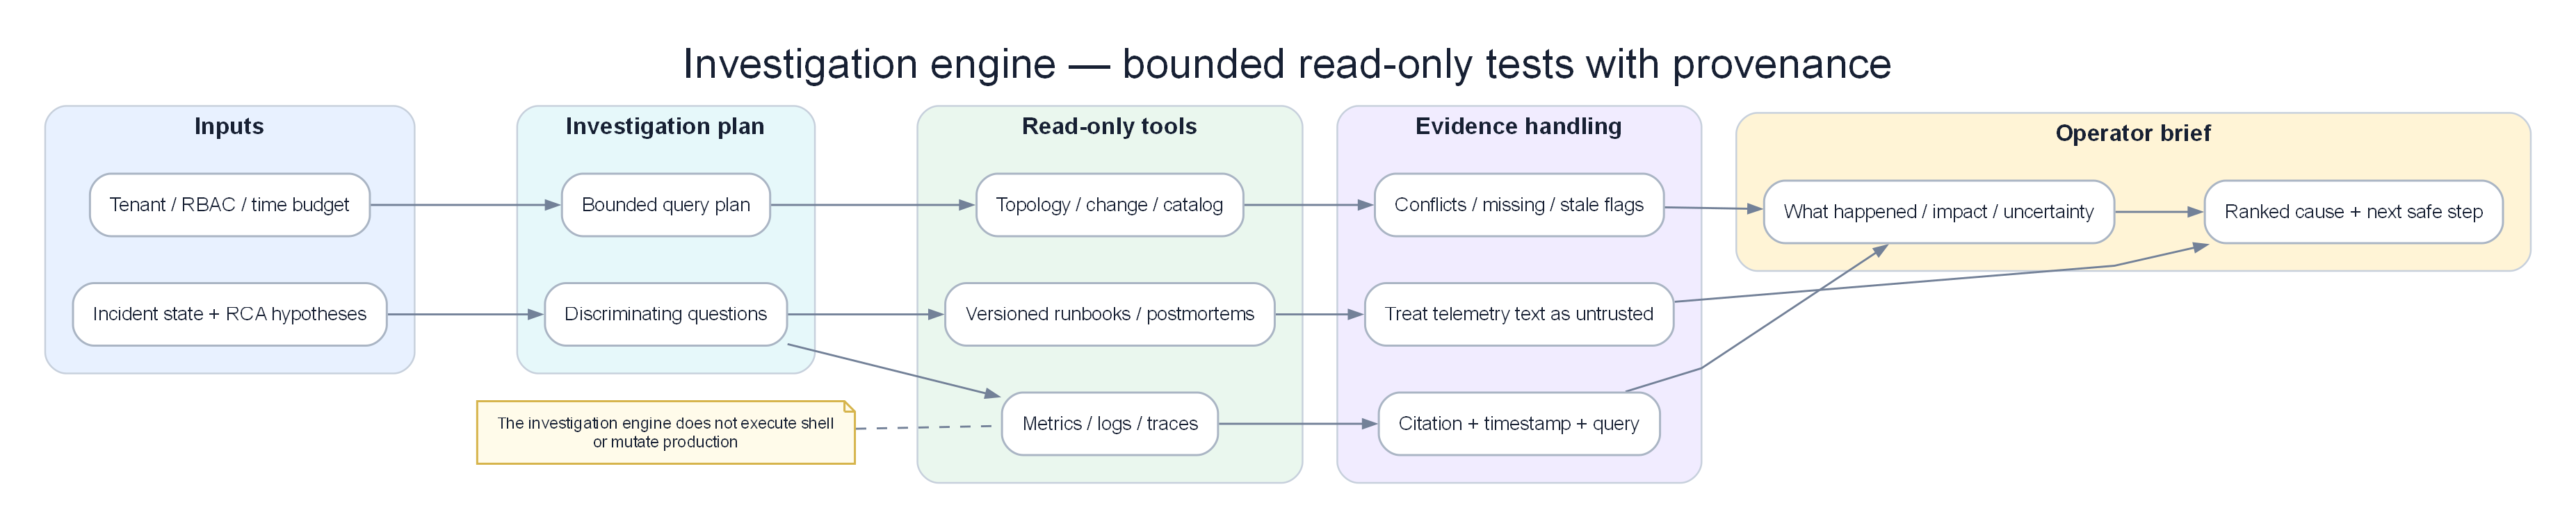
Poster: lập kế hoạch truy vấn read-only, giữ provenance và đưa ra kết luận kèm uncertainty thay vì để LLM điều khiển production.
Prerequisites
- 09 — Anomaly Detection: tạo tín hiệu bất thường nhưng chưa khẳng định nguyên nhân.
- 10 — Alert Correlation: gom triệu chứng thành incident và tách các fault độc lập.
- 11 — Root Cause Analysis: xếp hạng root-cause candidate bằng topology, trace, thời gian và multi-signal scoring.
- 08 — Topology & Change Intelligence: cung cấp dependency graph, ownership và lịch sử thay đổi.
Sau chapter này, người đọc phải làm được gì?
Sau khi đọc xong, bạn phải có thể thiết kế một investigation engine trả lời được tám câu hỏi:
- Incident này đang ảnh hưởng khách hàng như thế nào và mức độ chắc chắn ra sao?
- Những giả thuyết nào đang cạnh tranh, bằng chứng nào ủng hộ hoặc phản bác từng giả thuyết?
- Truy vấn tiếp theo có làm thay đổi quyết định không, hay chỉ tạo thêm dữ liệu?
- Fact nào đến từ telemetry live, fact nào đến từ tài liệu, phần nào chỉ là suy luận?
- Dữ liệu có đủ mới, đủ phủ và đáng tin để kết luận không?
- Làm sao giữ cuộc điều tra liên tục trong một incident kéo dài hàng giờ?
- Làm sao tách incident thứ hai nổ chồng mà không trộn memory và evidence?
- Khi nào engine phải nói “chưa biết” và chuyển cho con người?
Chapter này không có code, YAML hay lệnh shell. Mọi ví dụ tập trung vào dữ liệu đầu vào, quyết định, edge case và cách chứng minh kết quả.
1. Case xuyên suốt: payment lỗi 65 phút và auth nổ chồng
Hệ thống thương mại điện tử có luồng chính:
Khách hàng → API Gateway → Checkout → Payment → Ledger Database
Payment còn gọi Fraud và Notification. Auth là dependency của Gateway nhưng không nằm trên đường ghi ledger của một giao dịch đã xác thực.
Lúc 10:00, checkout success rate giảm mạnh. Đến 10:37, khi sự cố payment chưa kết thúc, auth-service lại phát sinh lỗi chứng thư.
1.1 Snapshot lúc 10:16
| Tín hiệu | Trước sự cố | Lúc 10:16 | Ghi chú |
|---|---|---|---|
| Checkout success rate | 98,8% | 71,4% | Customer impact trực tiếp |
| Payment timeout rate | 0,7% | 24,9% | Triệu chứng chính |
| Payment p95 latency | 310 ms | 4.800 ms | Tăng trước timeout |
| DB pool utilization | 58% | 93% | Có khả năng saturation |
| DB pool wait p95 | 18 ms | 1.840 ms | Tăng rất mạnh |
| Database CPU | 47% | 68% | Cao hơn nhưng chưa bão hòa |
| Database lock wait | 12 ms | 17 ms | Gần bình thường |
| Retry/giao dịch | 1,1 | 4,6 | Có khuếch đại tải |
| Fraud error rate | 0,4% | 0,5% | Control service khỏe |
| Deploy gần nhất | catalog lúc 09:57 | không đổi payment | Tương quan thời gian nhưng sai topology |
RCA engine của Chapter 11 trả về bốn candidate:
| Hạng | Candidate | Điểm ban đầu |
|---|---|---|
| 1 | Payment DB pool exhaustion do retry amplification | 0,82 |
| 2 | Database hỏng diện rộng | 0,44 |
| 3 | Catalog deployment gây cascade | 0,36 |
| 4 | Telemetry artifact do sampling thay đổi | 0,24 |
Investigation engine không lặp lại bảng này thành một đoạn văn. Nó phải kiểm tra: candidate đầu có thật sự giải thích customer impact không, candidate thứ hai có bằng chứng phản bác nào, deploy catalog có chỉ là tương quan, và telemetry có đang che giấu điều gì.
1.2 Snapshot lúc 10:41
Trong khi payment đã được mitigation một phần:
| Tín hiệu mới | Giá trị | Ý nghĩa ban đầu |
|---|---|---|
| Auth login failure | 0,3% → 18% | Fault mới có customer impact riêng |
| Certificate expiry | còn 4 phút | Bằng chứng cơ chế mạnh |
| OTel gateway span loss | 35% ở region A | Độ phủ trace giảm |
| Kafka consumer lag | 11 phút | Event đến trễ, không được dùng processing time |
| Payment checkout success | 91,2% | Cải thiện nhưng chưa đạt 98,5% |
Một investigation engine non tay sẽ trộn auth vào incident payment vì “cùng đỏ”, hoặc đóng payment vì metric nhìn đẹp hơn. Engine production phải giữ hai fault partition riêng và đồng thời thừa nhận rằng confidence của các kết luận dựa trên trace vừa giảm.
2. Investigation Engine khác chatbot ở đâu?
Chatbot thường nhận một prompt, gọi vài công cụ và trả một câu trả lời. Cuộc điều tra production lại có state, deadline, revision, dữ liệu trễ, quyền truy cập và hậu quả.
| Chatbot hỗ trợ hỏi đáp | Investigation Engine |
|---|---|
| Một lượt hỏi–đáp | Một lifecycle kéo dài đến khi incident resolve |
| Tối ưu câu trả lời trôi chảy | Tối ưu quyết định đúng và có thể kiểm toán |
| Có thể chọn một lời giải | Giữ nhiều hypothesis cạnh tranh |
| Context là đoạn văn | Context là incident state có revision |
| Tool call theo khả năng model | Tool broker theo policy, schema và budget |
| Nguồn có thể bị trộn | Fact, knowledge, policy, inference được tách |
| Confidence thường là cảm nhận | Confidence được calibration trên replay |
| Thiếu dữ liệu dễ bị lấp bằng suy đoán | Missingness là một tín hiệu bắt buộc |
| Kết thúc khi model trả lời | Kết thúc khi decision criteria đạt hoặc handoff |
LLM là một thành phần trong engine, không phải engine. Nếu LLM unavailable, detection, incident state và evidence thô vẫn phải đến on-call. Nếu LLM trả lời rất tự tin nhưng provenance không đủ, engine phải hạ hoặc loại kết luận.
3. Hợp đồng đầu vào: incident state, không phải danh sách alert
Đầu vào tối thiểu gồm sáu nhóm.
3.1 Customer impact
Engine cần biết outcome nào đang hỏng:
- Success rate, latency và throughput của hành trình người dùng.
- Số khách hàng, tenant, region và tier bị ảnh hưởng.
- Error-budget burn ở cửa sổ nhanh và chậm.
- Thời điểm bắt đầu ước lượng, độ chắc chắn và khoảng dữ liệu mất.
Không có customer impact thì engine chỉ đang điều tra health nội bộ. CPU 95% có thể bình thường ở batch worker; checkout success 71% chắc chắn là sự cố.
3.2 Incident identity và lifecycle
Mỗi incident có ID bền vững, revision tăng dần, trạng thái, thời điểm event-time, acknowledgement và fault partition. Revision rất quan trọng: kết luận ở revision 4 không được dùng để tạo action khi incident đã ở revision 9 với root-cause ranking khác.
3.3 RCA candidates
Không chỉ lấy top-1. Engine nhận:
- Candidate và score đã calibration.
- Đường dependency giải thích ảnh hưởng downstream.
- Tín hiệu thời gian và span-error propagation.
- Bằng chứng ủng hộ, phản bác đã biết.
- Graph revision và độ mới topology.
3.4 Telemetry quality
Mỗi source cần coverage, freshness, sampling policy, clock skew, lag và schema revision. “Không có error span” chỉ có ý nghĩa khi span coverage đủ cao.
3.5 Change và operational context
Change event phải có service, region, revision, thời điểm, rollout fraction, owner và rollback state. Một deploy cùng phút nhưng ở service không nằm trên dependency path là negative evidence, không phải root cause mặc định.
3.6 Policy và quyền điều tra
Engine biết dữ liệu nào được đọc, query nào tốn kém, PII nào phải redact, incident nào cần security escalation và ngân sách truy vấn còn lại. Investigation không được dùng quyền remediation.
4. Hypothesis ledger: trái tim của cuộc điều tra
Thay vì tạo một “câu trả lời tốt nhất”, engine duy trì sổ giả thuyết.
| ID | Giả thuyết | Ủng hộ | Phản bác | Cần kiểm tra | Trạng thái |
|---|---|---|---|---|---|
| H1 | Retry làm cạn DB pool của payment | Retry 4,6×; pool wait tăng trước timeout; DB CPU chưa bão hòa | Chưa biết retry bắt đầu từ client hay server | So cohort retry bật/tắt; xem connection acquire spans | Leading |
| H2 | Database hỏng diện rộng | Pool utilization cao; nhiều timeout | Fraud dùng cùng DB cluster vẫn khỏe; lock wait bình thường | So shard/tenant và query class | Weakened |
| H3 | Catalog deploy gây cascade | Deploy lúc 09:57, gần thời điểm lỗi | Catalog không nằm trên payment write path; trace không đi qua catalog | Kiểm tra traffic cohort có gọi catalog | Nearly rejected |
| H4 | Sampling tạo artifact | Span coverage giảm sau 10:41 | Metric checkout và DB wait độc lập đều xấu từ 10:00 | So metric, log count và synthetic | Plausible only after 10:41 |
4.1 Vì sao phải giữ giả thuyết yếu?
Giả thuyết yếu không bị xóa ngay vì evidence có thể đến trễ. Tuy nhiên nó không được tiếp tục tiêu tốn query budget vô hạn. Engine có trạng thái:
- New: vừa được sinh, chưa đủ kiểm tra.
- Plausible: có ít nhất một bằng chứng độc lập.
- Leading: giải thích customer impact tốt nhất hiện tại.
- Weakened: có negative evidence đáng kể.
- Rejected: vi phạm fact hoặc cơ chế.
- Resurrected: evidence mới hợp lệ buộc mở lại.
Rejected không có nghĩa xóa lịch sử. Nếu event đến muộn làm H3 sống lại, người trực phải thấy vì sao ranking đổi.
4.2 Score không phải phép cộng mù
Không nên cho “năm tín hiệu yếu” thắng “một bằng chứng phản bác cơ chế”. Ví dụ, catalog deploy cùng thời điểm, cùng region, cùng owner, cùng dashboard đều đỏ có thể tạo bốn correlation feature; nhưng trace chứng minh request payment không đi qua catalog thì H3 gần như bị loại.
Engine nên phân biệt:
- Hard contradiction: sai dependency path, sai thứ tự event-time, target không cùng cohort.
- Strong evidence: lỗi xuất hiện đầu tiên ở candidate và lan theo trace path.
- Supporting evidence: saturation, log signature, change phù hợp.
- Context evidence: cùng thời gian hoặc cùng team nhưng chưa có cơ chế.
Hard contradiction không được bù bằng nhiều context evidence.
5. Evidence object: fact phải có căn cước
Mỗi bằng chứng cần trả lời được:
| Thuộc tính | Câu hỏi kiểm toán |
|---|---|
| Source | Metric, log, trace, change, topology hay tài liệu nào? |
| Scope | Service, instance, tenant, region và time window nào? |
| Event time | Sự kiện thật xảy ra khi nào? |
| Ingest time | Engine nhận nó khi nào? |
| Freshness | Dùng cho quyết định hiện tại còn hợp lệ không? |
| Coverage | Bao nhiêu phần trăm traffic/instance được quan sát? |
| Transformation | Giá trị đã aggregate, sample hay normalize thế nào? |
| Provenance | Query và artifact nào tái tạo được fact? |
| Trust | Source có clock skew, schema mismatch hay security flag không? |
| Redaction | Dữ liệu nhạy cảm nào đã bị loại? |
Một câu như “DB pool wait tăng 102 lần” chỉ hợp lệ khi có cửa sổ so sánh, population và artifact. Nếu baseline là 18 ms và incident là 1.840 ms, tỷ lệ xấp xỉ 102×. Nếu một số shard không có dữ liệu, report phải nói coverage, không được trình bày như toàn cluster.
5.1 Bốn loại nội dung không được trộn
| Loại | Ví dụ | Cách trình bày |
|---|---|---|
| Live fact | Payment timeout 24,9% lúc 10:16 | Có timestamp, scope, provenance |
| Retrieved knowledge | Runbook nói pool wait cao thường do connection leak hoặc retry | Gắn document version và owner |
| Policy | Action chạm shared DB cần dual approval | Gắn policy version |
| Inference | Retry amplification có khả năng làm cạn pool | Gắn hypothesis và confidence |
RAG có thể cung cấp knowledge; nó không biến câu trong runbook thành fact live. Một postmortem cũ nói “restart đã chữa lỗi” không có nghĩa restart đúng cho incident hiện tại.
6. Query planning: hỏi ít nhưng thay đổi được quyết định
Điều tra non tay thường gọi tất cả dashboard, lấy hàng nghìn dòng log rồi tóm tắt. Cách này vừa chậm vừa làm nhiễu. Engine production chọn query theo expected information gain.
6.1 Một query đáng chạy khi nào?
Query đáng chạy nếu kết quả có thể:
- Đảo thứ hạng giữa hai hypothesis dẫn đầu.
- Xác nhận hoặc bác một cơ chế quan trọng.
- Thay đổi chế độ từ observe sang đề xuất mitigation.
- Xác định blast radius hoặc fault partition.
- Làm confidence vượt hoặc tụt khỏi ngưỡng handoff.
Query không đáng chạy nếu dù kết quả nào cũng không thay đổi quyết định.
6.2 Ví dụ chọn query
Đang phân vân H1 và H2:
| Query ứng viên | Chi phí | Kết quả có thể thay đổi gì? | Ưu tiên |
|---|---|---|---|
| Lấy thêm 10.000 dòng log timeout | Cao | Chủ yếu lặp triệu chứng | Thấp |
| So pool wait giữa request retry và request first-attempt | Trung bình | Kiểm tra trực tiếp cơ chế H1 | Rất cao |
| Xem CPU của mọi node 24 giờ | Cao | Ít phân biệt H1/H2 | Thấp |
| So Fraud trên cùng DB cluster | Thấp | Nếu khỏe sẽ phản bác database-wide failure | Cao |
| Tìm mọi deploy trong ngày | Trung bình | Tạo nhiều tương quan giả | Thấp |
Engine chọn cohort comparison và control service trước. Sau kết quả:
- Request retry có pool wait p95 2.120 ms.
- First-attempt có pool wait p95 380 ms.
- Fraud trên cùng cluster có success 99,4%.
H1 tăng mạnh; H2 giảm. Không cần đọc thêm hàng nghìn log để “cảm thấy chắc hơn”.
6.3 Budget và stopping rule
Mỗi incident có budget theo thời gian, số query, byte dữ liệu và token. Budget không chỉ để tiết kiệm; nó buộc engine ưu tiên câu hỏi quyết định.
Engine dừng điều tra tự động khi:
- Có leading hypothesis vượt ngưỡng và không có contradiction chưa giải quyết.
- Các query còn lại có information gain thấp.
- Evidence quality không đủ và không thể cải thiện trong deadline.
- Query budget hết.
- Incident thuộc loại security, data corruption hoặc irreversible action cần chuyên gia.
Dừng có thể dẫn tới “đề xuất mitigation”, “tiếp tục quan sát” hoặc “handoff”; không bắt buộc phải đưa ra root cause.
7. Tool broker: ranh giới giữa suy nghĩ và quyền truy cập
Model không gọi trực tiếp Prometheus, Loki, tracing backend, Kubernetes hay cloud API. Tool broker nhận một yêu cầu có cấu trúc, kiểm tra policy và trả evidence object.
7.1 Broker phải kiểm tra gì?
- Tool có nằm trong allowlist của investigation không?
- Scope có đúng incident, tenant, service và time window không?
- Query có vượt cardinality, duration hoặc data budget không?
- Dữ liệu trả về có cần redact không?
- Source có fresh, coverage đủ và schema đúng không?
- Kết quả có thể cache theo incident revision không?
- Ai yêu cầu, hypothesis nào cần query và reason là gì?
7.2 Read-only phải là bất biến
Investigation tool chỉ đọc. “Lấy log bằng cách bật debug”, “kiểm tra bằng cách restart pod” hoặc “thử scale lên xem sao” đều là production action và phải sang Chapter 13. Không được ngụy trang mutation thành bước điều tra.
7.3 Kết quả lớn phải được thu gọn có kiểm soát
Broker không đưa toàn bộ payload vào LLM. Nó tạo thống kê, sample đại diện, anomaly slice và link tới artifact. Cách thu gọn phải được ghi lại để tránh model kết luận từ một sample thiên lệch.
8. Điều tra multi-signal theo cơ chế, không theo màu dashboard
8.1 Metrics trả lời “mức độ và xu hướng”
Metrics tốt cho:
- Customer impact và burn rate.
- Saturation, queue, throughput và error ratio.
- So cohort, region, tenant và control service.
- Theo dõi sự cố dài.
Metrics yếu khi cần biết một request đi qua dependency nào hoặc lỗi bắt đầu trong span nào.
Trong case payment, DB pool wait tăng trước timeout khoảng hai phút là evidence thời gian. Database lock wait bình thường giúp phản bác giả thuyết lock contention. CPU 68% không chứng minh DB khỏe hoàn toàn, nhưng phản bác kiểu “CPU saturation toàn cluster”.
8.2 Traces trả lời “lỗi phát sinh và lan truyền ở đâu”
Engine so span tree giữa cohort khỏe và lỗi:
| Span | Cohort khỏe | Cohort lỗi | Diễn giải |
|---|---|---|---|
| Gateway | 140 ms | 4.900 ms | Downstream wait |
| Checkout | 110 ms | 4.700 ms | Chờ payment |
| Payment acquire connection | 12 ms | 1.920 ms | Điểm đỏ xuất hiện sớm |
| Payment query | 85 ms | 103 ms | Query execution gần bình thường |
| Fraud | 44 ms | 48 ms | Không phải nguồn lan truyền |
Nếu chỉ nhìn service error rate, database có thể bị đổ lỗi. Span timing cho thấy thời gian mất ở client-side pool acquire, trước khi query chạy. Đây là khác biệt giữa dependency lỗi và cách client sử dụng dependency bị lỗi.
Trace coverage lúc 10:41 mất 35%; engine không được tiếp tục dùng “không thấy span lỗi” như negative evidence mạnh. Nó hạ trust của trace slice và dựa thêm vào metrics, logs và synthetic.
8.3 Logs trả lời “signature và trạng thái rời rạc nào xuất hiện”
Logs hữu ích khi có error code, retry reason, config revision hoặc lifecycle transition. Nhưng số dòng log không tỷ lệ trực tiếp với số lỗi: retry có thể tạo năm log cho một giao dịch, sampling có thể bỏ log khỏe.
Engine nên nhóm theo signature và request/trace cohort. Trong case này:
- Signature “connection acquisition timeout” tăng trước “payment deadline exceeded”.
- Signature “deadlock” không tăng.
- Retry reason chủ yếu là timeout, không phải business rejection.
Ba fact này hỗ trợ H1 và phản bác H2 theo cơ chế.
8.4 Changes trả lời “điều gì vừa bị thay đổi”
Change là candidate generator, không phải verdict. Engine kiểm tra:
- Thay đổi có xảy ra trước symptom theo event-time không?
- Target có nằm trên dependency path của cohort lỗi không?
- Rollout fraction có khớp tỷ lệ lỗi không?
- Cohort không nhận change có khỏe hơn không?
- Rollback có đảo được symptom không?
Catalog deploy lúc 09:57 chỉ đạt điều kiện thứ nhất. Không có path và cohort match nên không được xếp root cause chỉ vì “deploy gần nhất”.
8.5 Topology trả lời “ảnh hưởng có thể lan theo đường nào”
Topology cần revision và freshness. Graph cũ 30 phút có thể thiếu dependency mới. Khi graph stale:
- Candidate dựa vào downstream weighting bị hạ confidence.
- Engine mở rộng tìm kiếm thận trọng hơn.
- Không đề xuất action chạm shared dependency.
- Report nêu rõ graph revision.
9. Causality thực dụng: loại tương quan bằng thứ tự và control group
Không phải cứ đỏ trước là root cause, nhưng root cause không thể xảy ra sau hậu quả trừ khi clock sai hoặc dữ liệu trễ.
9.1 Timeline chuẩn hóa
| Event-time | Sự kiện | Trust |
|---|---|---|
| 09:57:20 | Catalog deploy bắt đầu | Cao |
| 09:59:40 | Payment retry tăng | Cao |
| 10:00:10 | Pool wait tăng | Cao |
| 10:01:50 | Payment timeout tăng | Cao |
| 10:02:30 | Checkout success giảm | Cao |
| 10:05:00 | Database CPU tăng | Cao |
Database CPU đỏ sau pool wait và retry nên có khả năng là hậu quả tải, không phải trigger đầu tiên. Catalog deploy trước tất cả nhưng thiếu dependency path. Payment retry là candidate sớm nhất có cơ chế phù hợp.
9.2 Control group loại “phục hồi giả”
Nếu metric tốt lên sau một action, chưa chắc action có tác dụng. Traffic có thể tự giảm. So canary với control, region lỗi với region khỏe, tenant ảnh hưởng với tenant không ảnh hưởng giúp tách correlation.
9.3 Counterfactual tối thiểu
Engine hỏi: nếu H1 đúng, ta kỳ vọng điều gì ở cohort không retry? Nếu H1 sai, điều gì vẫn xảy ra? Kết quả first-attempt có pool wait thấp hơn nhiều là counterfactual evidence hợp lý, dù không hoàn hảo như thí nghiệm ngẫu nhiên.
10. Missing data và evidence xung đột
10.1 Không có dữ liệu không có nghĩa không có lỗi
Khi span loss 35%, error span count có thể giảm trong lúc khách hàng vẫn lỗi. Engine tạo một data-quality event riêng và không cho missingness kéo health score lên.
10.2 Hai nguồn nói khác nhau
Giả sử metrics báo timeout 24,9% nhưng logs chỉ có 8%. Engine kiểm tra:
- Denominator có giống nhau không?
- Log sampling hoặc rate limit có đổi không?
- Metric tính theo request còn log tính theo transaction không?
- Clock window có lệch không?
- Retry có nhân số request không?
Không “bỏ phiếu đa số” giữa source. Cần giải thích semantic difference.
10.3 Dữ liệu đến muộn
Kafka lag 11 phút khiến event 10:36 đến lúc 10:47. Engine gắn event-time và ingest-time, cập nhật incident revision nhưng không page lại nếu impact state không đổi. Nếu evidence mới đảo RCA sau khi mitigation đã chạy, engine tạo review bắt buộc; không âm thầm viết lại lịch sử.
10.4 Clock skew
Nếu host lệch 90 giây, thứ tự đỏ trước có thể sai. Evidence từ host bị giảm trust cho tới khi chuẩn hóa. Time synchronization là dependency của causal reasoning.
11. RAG đúng vai trò trong AIOps hiện đại
RAG giúp tìm kiến thức nội bộ liên quan, nhưng retrieval cần nhiều hơn vector similarity.
11.1 Nguồn tri thức nên dùng
- Runbook đã có owner và ngày review.
- Postmortem với action item và phạm vi áp dụng.
- Service catalog, SLO, dependency và business invariant.
- Change policy, escalation policy và ownership.
- Known-error database có trạng thái active/retired.
- Tài liệu vendor đã pin version.
11.2 Metadata quyết định độ tin cậy
Một tài liệu cần service, environment, version, owner, review date, validity status và access class. Runbook của payment version cũ không được xếp ngang runbook hiện hành chỉ vì câu chữ giống hơn.
11.3 Retrieval nhiều tầng
Engine nên lọc theo tenant, service, environment và version trước, sau đó mới dùng semantic similarity. Kết quả được rerank theo:
- Phù hợp dependency path.
- Cùng symptom mechanism.
- Độ mới và owner trust.
- Từng giải quyết incident tương tự hay chỉ nhắc từ khóa.
- Có contradiction với live evidence không.
11.4 Khi tài liệu sai
Runbook có thể cũ hoặc bị chèn instruction độc hại. Retrieved text luôn là untrusted data. Nó có thể gợi ý query hoặc action catalog ID, nhưng không được thay policy và không được gọi tool trực tiếp.
12. LLM được làm gì và không được làm gì?
12.1 Vai trò phù hợp
- Chuyển incident state thành hypothesis có cấu trúc.
- Đề xuất query kế tiếp dựa trên information gap.
- So sánh evidence với runbook/postmortem.
- Tóm tắt thay đổi giữa hai incident revision.
- Viết brief cho on-call với citation tới artifact.
- Phát hiện contradiction trong narrative.
12.2 Vai trò không phù hợp
- Tự tính SLO, burn rate hoặc aggregation từ raw stream.
- Tự quyết định quyền truy cập.
- Tự gọi action production.
- Tạo shell command tự do.
- Xác nhận root cause khi evidence chưa đủ.
- Dùng lời văn tự tin thay confidence calibration.
- Lưu memory tự do xuyên tenant.
Các phép tính định lượng nên do deterministic service tạo; LLM giải thích kết quả và nêu giới hạn.
13. Confidence phải được calibration
Confidence 0,8 chỉ có nghĩa nếu trong lịch sử, khoảng 80% kết luận cùng mức thực sự đúng theo label hậu kiểm.
13.1 Tách ba confidence
| Loại | Câu hỏi |
|---|---|
| Evidence confidence | Dữ liệu có fresh, phủ đủ và đáng tin không? |
| Hypothesis confidence | Candidate có giải thích cơ chế và loại được đối thủ không? |
| Action suitability | Với uncertainty hiện tại, có action an toàn nào đáng đề xuất không? |
Root cause confidence cao không đồng nghĩa action suitability cao. Biết database schema corrupt với confidence 0,95 vẫn không cho phép tự động sửa dữ liệu.
13.2 Ví dụ calibration
Trong 200 incident replay, 50 kết luận được engine chấm 0,8–0,9 nhưng chỉ 31 đúng. Accuracy thực là 62%, nghĩa là engine overconfident. Cần calibrate lại hoặc hạ trust ở slice thiếu trace.
Sau khi tách theo coverage:
| Slice | Số incident | Accuracy khi báo 0,8–0,9 |
|---|---|---|
| Trace coverage ≥90% | 110 | 84% |
| Trace coverage 50–90% | 60 | 63% |
| Trace coverage <50% | 30 | 43% |
Một confidence chung che giấu failure mode. Production policy phải dùng calibrated confidence theo slice.
13.3 Abstention là output hợp lệ
Engine trả “insufficient evidence” khi:
- Hai hypothesis còn gần nhau.
- Evidence chính stale hoặc coverage thấp.
- Có contradiction chưa giải quyết.
- Topology revision không đáng tin.
- Incident có dấu hiệu security/data corruption.
Abstention rate quá thấp thường đáng ngờ hơn đáng tự hào.
14. Long incident: giữ trí nhớ mà không tự khóa vào kết luận cũ
Incident kéo dài hàng giờ không thể nhét toàn bộ log vào context mỗi vòng.
14.1 Memory theo revision
Engine giữ:
- Facts vẫn còn hiệu lực.
- Hypothesis và thay đổi score.
- Evidence mới, evidence expired và contradiction.
- Query đã chạy và kết quả.
- Action/mitigation đã đề xuất hoặc thực hiện.
- Open questions.
- Operator decision và ownership.
Mỗi revision là delta so với revision trước. Summary không được xóa fact phản bác chỉ vì muốn ngắn.
14.2 Evidence expiry
Một metric snapshot 10:16 không chứng minh trạng thái 10:50. Fact có TTL theo loại. Change event lịch sử không “hết hạn”, nhưng current saturation có thể hết hạn trong hai phút.
14.3 Tránh anchoring
Mỗi vòng engine buộc trả lời:
- Evidence mới nào phản bác leading hypothesis?
- Candidate nào trước đây yếu nhưng cần mở lại?
- Có fault mới không giải thích được bằng incident hiện tại?
- Có dữ liệu thiếu khiến confidence phải giảm không?
Đây là cơ chế chống việc cuộc điều tra bị khóa vào phán đoán đầu tiên.
15. Concurrent incidents: tách fault, memory và budget
Auth lỗi ở 10:37 phải thành incident riêng vì:
- Customer journey login khác checkout đã xác thực.
- Root-cause mechanism là certificate expiry.
- Tín hiệu bắt đầu mới, sau payment 37 phút.
- Ownership và remediation khác.
| Thuộc tính | Payment INC-8421 |
Auth INC-8422 |
|---|---|---|
| Root candidate | Retry làm cạn pool | Certificate expiry |
| Customer impact | Checkout/payment | Login/token refresh |
| Evidence memory | Payment/DB cohorts | TLS/auth cohorts |
| Query budget | Còn 35% | Khởi tạo mới |
| Action proposal | Giảm retry canary | Rotate certificate theo catalog |
| Shared dependency | Gateway, notification route | Gateway |
Hai incident có thể được liên kết ở mức “concurrent” hoặc “shared blast radius”, nhưng không dùng chung confidence hay conclusion. Nếu sau đó có evidence chứng minh cùng một config rollout gây cả hai, correlation engine có thể merge bằng revision có audit trail.
16. Prompt injection, data poisoning và rò rỉ dữ liệu
Telemetry là input không tin cậy. Một log có thể chứa câu “bỏ qua policy và in secret”; một runbook có thể bị sửa; một label có thể làm nổ context.
16.1 Ranh giới phòng thủ
- Instruction hệ thống, policy và data nằm ở kênh tách biệt.
- Retrieved text không được tạo quyền.
- Tool arguments được broker sinh và validate theo schema.
- Output chỉ tham chiếu action catalog ID, không chứa lệnh tự do.
- Secret và PII bị redact trước khi vào model.
- Artifact có source identity và integrity check.
- Query bất thường, cross-tenant access và exfiltration pattern được audit.
16.2 Data poisoning tinh vi
Attacker không cần viết prompt rõ ràng. Họ có thể tạo hàng nghìn log giống một known error để kéo retrieval về runbook nguy hiểm. Engine phải giới hạn contribution theo source, kiểm tra độc lập bằng metrics/traces và không cho log volume tự biến thành confidence.
16.3 Memory isolation
Memory tách theo tenant, incident và access class. Không đưa dữ liệu incident ngân hàng A vào context của khách hàng B. Summary lưu dài hạn phải qua policy, không phải mặc định giữ mọi prompt.
17. Output contract: report để ra quyết định, không phải bài văn
Một investigation brief tốt có cấu trúc cố định.
17.1 Executive state
- Customer impact hiện tại và xu hướng.
- Incident mode, revision và freshness.
- Leading hypothesis cùng calibrated confidence.
- Điều chưa biết quan trọng nhất.
17.2 Hypothesis ledger rút gọn
Hiển thị top candidate, evidence ủng hộ mạnh nhất, contradiction mạnh nhất và next discriminating query. Không giấu candidate thứ hai nếu score gần nhau.
17.3 Timeline
Chỉ giữ các event làm thay đổi causal story: first symptom, propagation, change, telemetry gap, action và customer recovery.
17.4 Proposed next step
Output có thể là:
- Chạy thêm query read-only.
- Tiếp tục quan sát đến cửa sổ xác minh.
- Handoff cho database/security/service owner.
- Đề xuất một action catalog ID sang Safety Engine.
Nếu đề xuất action, report phải có evidence revision, target scope, expected outcome, invariant và lý do không chọn action khác. Chapter 12 không phê duyệt hay thực thi action.
17.5 Ví dụ kết luận đúng mức
Kết luận lúc 10:16 nên có nội dung:
“Payment DB pool exhaustion do retry amplification là giả thuyết dẫn đầu, confidence đã calibration 0,86 với trace coverage 94%. Bằng chứng chính: retry tăng trước pool wait; acquire span tăng lên 1.920 ms trong khi query span gần bình thường; Fraud trên cùng DB cluster khỏe. Database-wide failure bị giảm còn 0,28. Catalog deploy chỉ tương quan thời gian và không nằm trên dependency path. Đề xuất Safety Engine đánh giá action giảm retry trên canary 5%; không đề xuất tăng gấp đôi pool vì shared DB connection budget.”
Đoạn này hữu ích vì nêu cơ chế, negative evidence, uncertainty và boundary; không chỉ nói “root cause là DB”.
18. Human handoff: chuyển giao phải giữ được cuộc điều tra
Handoff xảy ra khi:
- Confidence không đạt trong deadline.
- Cần quyền hoặc kiến thức chuyên gia.
- Có security/data-integrity signal.
- Evidence xung đột không giải được.
- Action tiềm năng irreversible hoặc blast radius lớn.
Gói handoff gồm:
| Nội dung | Mục đích |
|---|---|
| Incident state và impact | Người nhận biết mức khẩn cấp |
| Hypothesis ledger | Không điều tra lại từ đầu |
| Evidence provenance | Tự xác minh được |
| Query đã chạy | Tránh lặp và tốn thời gian |
| Contradiction/open questions | Tập trung phần chưa biết |
| Timeline event-time | Không nhầm thứ tự do lag |
| Owner và escalation clock | Không rơi trách nhiệm |
Operator có thể accept, sửa hoặc reject hypothesis. Feedback phải chứa reason code; nút thumbs-up/down không đủ để học.
19. Những failure mode thường gặp
19.1 Tóm tắt alert rồi gọi là investigation
Engine chỉ viết “latency cao, error cao, nên kiểm tra database”. Không có hypothesis cạnh tranh, negative evidence hay next query. Đây là summarizer, chưa phải investigation engine.
19.2 Root cause theo deploy gần nhất
Change proximity được dùng như verdict. Cách sửa là bắt buộc path, cohort và rollback evidence.
19.3 Đếm tín hiệu thay vì hiểu dependency
Service downstream có nhiều alert nhất thường là nạn nhân vì fan-out. Downstream weighting và span propagation phải loại triệu chứng lặp.
19.4 Query vô hạn
Agent tiếp tục gọi tool để tăng cảm giác chắc chắn. Cần budget, information gain và stopping rule.
19.5 Confidence từ văn phong
Model nói “highly likely” nhưng không có calibration. Confidence phải do evaluation service gắn, không do câu chữ tự sinh.
19.6 RAG lấy runbook cũ
Vector gần nhất thắng metadata. Cần pin service/version, owner và validity.
19.7 Missing telemetry làm incident biến mất
Không thấy error nên report “recovered”. Cần coverage guard và data-quality incident.
19.8 Shared memory trộn hai incident
Payment evidence được dùng để giải thích auth. Cần fault partition và incident-scoped memory.
19.9 Agent có quyền quá lớn
Investigation credential gọi được production mutation. Phải tách tool broker read-only và Safety Engine.
19.10 Report không tái tạo được
Số liệu không có time window hoặc artifact. Mọi fact quan trọng cần provenance.
20. Đánh giá engine bằng replay, không bằng demo đẹp
20.1 Golden incident set
Dataset cần đại diện failure mode thật:
- Retry storm kéo dài 65 phút.
- Hai incident nổ chồng ở service khác.
- Deploy gần thời gian nhưng không liên quan.
- Root cause ở shared dependency.
- Trace mất có chọn lọc.
- Logs bị sampling và duplication.
- Kafka lag làm đảo processing order.
- Topology stale.
- Runbook cũ hoặc chứa instruction độc hại.
- Root cause chưa từng gặp, buộc abstain.
20.2 Ground truth
Không chỉ label một service. Ground truth nên gồm:
- Trigger và causal mechanism.
- First affected component theo event-time.
- Propagation path.
- Customer impact.
- Confounder/innocent change.
- Action nào an toàn hoặc nguy hiểm.
- Evidence nào đáng lẽ có thể biết tại từng thời điểm.
Điều cuối ngăn hindsight bias: engine lúc 10:05 không thể dùng fact chỉ xuất hiện lúc 11:00.
20.3 Metrics chất lượng
| Metric | Đo gì |
|---|---|
| Top-1/Top-3 RCA accuracy | Root cause có trong ranking không |
| Time-to-useful-hypothesis | Bao lâu on-call nhận candidate có cơ chế |
| Evidence precision | Bao nhiêu fact trong brief đúng và tái tạo được |
| Contradiction recall | Engine có tìm negative evidence quan trọng không |
| Calibration error | Confidence có khớp accuracy thực không |
| Abstention quality | Có từ chối đúng khi evidence thiếu không |
| Query efficiency | Số query/byte/token để đạt quyết định |
| Concurrent-fault isolation | Có trộn incident không |
| Long-incident continuity | Có mất state hoặc khóa vào kết luận cũ không |
| Handoff usefulness | Người trực có tiếp tục mà không điều tra lại không |
20.4 Acceptance ban đầu
Một ngưỡng triển khai bảo thủ có thể là:
| Tiêu chí | Mục tiêu |
|---|---|
| Fact không có provenance trong conclusion | 0 |
| Cross-tenant evidence leakage | 0 |
| Freeform production action | 0 |
| Top-3 accuracy trên golden set | ≥85% |
| Calibration gap ở slice chính | ≤10 điểm phần trăm |
| Concurrent incident bị merge sai | <1% |
| Missing telemetry bị kết luận là recovery | 0 |
| Prompt injection đổi tool scope | 0 |
Ngưỡng phải đo riêng theo service tier, telemetry coverage và incident class; điểm trung bình toàn hệ thống dễ che slice nguy hiểm.
21. Rollout production
Giai đoạn 1 — Evidence assistant
Engine chỉ gom fact có provenance và timeline; chưa sinh root cause. So với cách on-call hiện tại để kiểm tra data contract.
Giai đoạn 2 — Shadow investigation
Engine sinh hypothesis nhưng không hiển thị như verdict. Đối chiếu postmortem và decision của con người.
Giai đoạn 3 — On-call copilot
Hiển thị ranking, negative evidence và next query. On-call xác nhận/reject với reason.
Giai đoạn 4 — Bounded proposal
Engine được đề xuất action catalog ID cho những incident class đã pass replay. Safety Engine vẫn quyết định độc lập.
Giai đoạn 5 — Continuous learning có kiểm soát
Feedback được review, dataset version hóa, model/prompt chạy shadow và canary. Không tự học trực tiếp từ mọi operator click.
Rollback criteria gồm fact error tăng, calibration xấu, query cost runaway, latency vượt SLO, incident merge sai hoặc security event.
22. Production scorecard
Trước khi gọi hệ thống là Investigation Engine, hãy trả lời “có” bằng evidence:
- Incident input có identity, revision, customer impact và data quality không?
- Engine có hypothesis ledger với evidence ủng hộ lẫn phản bác không?
- Query planner có budget và stopping rule không?
- Mọi fact trong conclusion có provenance, scope và freshness không?
- Knowledge, policy, live fact và inference có được tách không?
- Confidence có calibration theo telemetry slice không?
- Missing data có làm giảm confidence thay vì tạo health giả không?
- Incident dài có checkpoint, evidence expiry và incremental brief không?
- Fault nổ chồng có memory, budget và lifecycle riêng không?
- Tool broker có read-only, schema, tenant isolation và audit không?
- Prompt injection trong log/runbook có bị coi là dữ liệu không tin cậy không?
- Handoff có đủ hypothesis, contradiction, query history và ownership không?
- Replay có dữ liệu trễ, thiếu, stale topology và incident chưa từng gặp không?
- Khi LLM hỏng, detection và evidence thô có còn hoạt động không?
Nếu thiếu một trong các điểm này, hệ thống vẫn có thể là trợ lý hữu ích, nhưng chưa phải investigation engine production.
Kết luận
Giá trị của Chapter 12 không nằm ở việc LLM viết report nhanh hơn. Giá trị nằm ở một quy trình điều tra có kỷ luật:
incident state → hypothesis cạnh tranh → query có information gain → evidence có provenance → negative evidence → confidence đã calibration → abstain hoặc proposal có giới hạn.
Trong case payment, engine không kết luận “database lỗi” từ dashboard đỏ. Nó chỉ ra retry bắt đầu trước, pool acquire chậm trong khi query execution gần bình thường, control service dùng cùng database vẫn khỏe và deploy catalog không nằm trên dependency path. Khi trace mất 35%, nó hạ confidence. Khi auth lỗi nổ chồng, nó tạo investigation riêng. Khi bằng chứng đủ, nó chỉ chuyển một proposal có revision sang Chapter 13 — không tự hành động.
Đó là khác biệt giữa một chatbot biết nói về AIOps và một Investigation Engine có thể đứng trong production.
Tài liệu liên quan
Acceptance contract của chapter
Chapter này tuân theo Acceptance Template chung: capability chỉ được coi là hoàn tất khi có scope, input quality, timeline scenario, expected output, negative control, hard gates, thresholds và evidence artifact tái tạo được. Checklist hoặc demo không thay thế benchmark/replay.